

400-820-8531
 图1. 应用场景质谱的血清质组学发展历程(图源:Shuken, J Proteome Res, 2023)
01.数据源研究分析:多肽判定
每次LC-MS/MS开机运行呈现的原有动态参数统计资料集有的是个大的光谱图图汇总,每一款 光谱图图都有着保存时间间隔、m/z值、強度和元动态参数统计资料。实用MaxQuant或Proteome Discoverer(Thermo Fisher Scientific)等APP包清理这动态参数统计资料,导出肽和/或核膳食纤维下拉列表,每一款 自动识别都有着一款 总分。很往往非靶向治疗的自下而上的DDA核膳食纤维组学调查中实用的通常用的肽监定措施为动态参数统计资料库浏览(图2)。
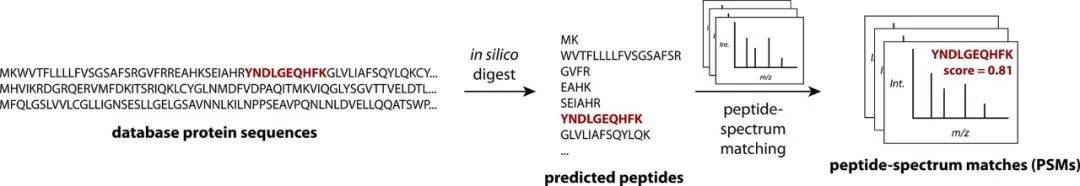 图2. 数值库搜索网页的简化版介绍(图源:Shuken, J Proteome Res, 2023)
 图3. 小鼠Hexokinase-1的胺基酸回文序列(图源:Shuken, J Proteome Res, 2023)
 图4. 场面描写m/z值、带批注的MS2谱,或是图3中严重体现 的场面描写编码序列(NILIDFTK)
1.1 数剧库搜所优化算法例子:SEQUEST的抽象化形容
SEQUEST是199历经四年发稿的第一家全半自动肽判别图片软件。图5教学片了SEQUEST数学模型的要学会简化名词解释。一方面,对决定性蛋清质组分析分析的肽使用油烟净化器,并能只顾虑与溶合的裂开阴铁离子的m/z值相拟的前体(即正电荷动态特喜欢的人肽阴铁离子),第三形成本体论研究光谱分析图仪仪分析分析分析图分析图图(图5,顶上)。用将检测光谱分析图仪仪分析分析分析图分析图图与分析分析细节描写的m/z值使用粗略地非常,本体论研究光谱分析图仪仪分析分析分析图分析图图被高速油烟净化器,匹配好细节描写的用户、MS2比強度和其他一些相应结构特征结制作而成一家高考总成绩,仅调取依据该高考总成绩的前500个本体论研究光谱分析图仪仪分析分析分析图分析图图(图5,步奏1)。用解除前体峰,将光谱分析图仪仪分析分析分析图分析图图界定为五个问题的区,并将一个区的比強度归一化成差不多的值来进行调节检测光谱分析图仪仪分析分析分析图分析图图(图5,步奏2),这几步使检测光谱分析图仪仪分析分析分析图分析图图更达到本体论研究光谱分析图仪仪分析分析分析图分析图图,减掉了创设本体论研究光谱分析图仪仪分析分析分析图分析图图时给忽略的可变性勾玉化使用率的。用将一个m/z值处的比強度相乘并将乘积结合,计算公式检测光谱分析图仪仪分析分析分析图分析图图与一个本体论研究光谱分析图仪仪分析分析分析图分析图图直接的能够 内在联系(图5,步奏3)。
 图5. 减化了原SEQUEST数据表格库收索计算方式的预案(图源:Shuken, J Proteome Res, 2023)
1.2 肽签定中的FDR管理
他们如此选择哪几个评分足以高来代表实际存在的ID?现有即可,最留行的方式 是 Target-decoy搜(图6)。该的过程掌握当前有误知道率(FDR),即被确认的PSM有误的最低值数量。从而在掌握FDR的同時最好局限地判断真肽,能否运用搜评分和PSM的任何表现的线形三人组合名字(图6)。线形三人组合名字中运用的常数{a, b,…}被网站SEO以最好局限地判断真肽,通畅运用percolator运用的产品學習算法流程图。还有网站SEO成功完成后,全部高出所须FDR使用阈值法的目标值适应(随后,1%)被补齐。这是净化统计数据集的FDR通常是指“当前”FDR。
 图6. Target-decoy搜到。PSM=肽谱识别;FDR =内部错误看见率(图源:Shuken, J Proteome
02.肽段定量分析
有效率色谱仪色谱在整一个工作时候中反复地将多肽喷雾器到质谱仪中。没个扫锚周期长一个,基本必须 3 s或越少,光谱仪图仪诞生MS1光谱仪图;从而,在有效率色谱仪离子交换柱冲洗掉时候中,前体的MS1峰定期被观查到2次,他们MS1的数据点一齐进行色谱峰(图7A)。给定既定的肽,其色谱峰的特征描述,要是极高或的身材曲线上面积(AUC),可以使用于在测量肽的相对来说丰度,这被通常是指非标准记化学发光法(LFQ),该措施可以使用于不一样印刷品中的使用量对比。 为了能让增长按量重演性、样板通量和/或数据统计完整篇性,标志检查是否药品该用于按量同样一质谱中的诸多微动物工程技术技术样板。在这个措施中,除了有有所差异的放射性核素诱发肽或其细节描写的m/z值有所差异外,肽被标志为雷同的分子群,还补齐检查是否特性,如补齐精力、电离性和细节描写策略。在基础代谢标志措施中,如内部塑造有机酸稳定的放射性核素标志(SILAC),用微动物工程技术技术系统性将包含有重放射性核素的有机酸标志全部蛋清质组。在样板制得开使时,将天然冰“轻”蛋清与重蛋清相结合,再与MS1光谱仪进行较为(图7B)。在等压法(即安全性能等于,是由于有所差异的tag标示存在雷同的总安全性能)标志措施中,如串连安全性能tag标示(TMT),肽段在代谢后被标志,再在LC-MS/MS前组成。较高能CID(HCD)为所有微动物工程技术技术样板保持有所差异的上报铁铁离子;在MS2或MS3扫码在线测量上报铁铁离子挠度,也应该推论出相对来说丰度(图7C)。在用到LFQ,很久加载定性数据分析一下一款微动物工程技术技术子范例;在用到SILAC,很久加载往往定性数据分析一下两到以下三个微动物工程技术技术子范例;在用到TMT,每次也应该定性数据分析一下多至18种有所差异的微动物工程技术技术子范例。
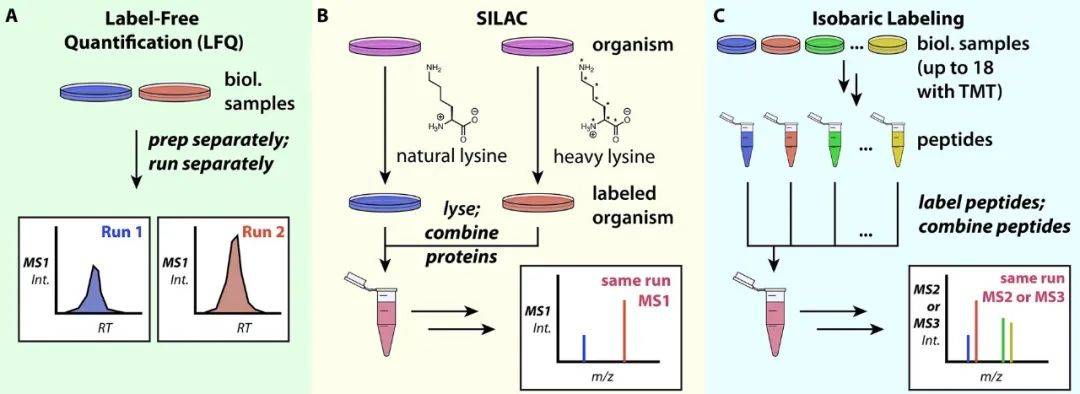 图7. 多肽酶联免疫法办法。A.在MS1质量进行非标设备记酶联免疫法;B. 肿瘤细胞锻炼中核苷酸动态平衡放射性核素标出(SILAC);C. 等压标出
03.“血清质水平方向”:推测血清质的特征和丰度
3.1 蛋白酶质推算与分成小组
既然一系列用自下而上氨基酸质组学提及了“氨基酸质”的个人信息和比例,但它一般性是监定和/或量化分析氨基酸质群,其起源地的氨基酸质或遗传基因几率是不明确的的。对这款语病,最经分类的搞定方式是用每台PSM当做样板中有以及氨基酸质的书证。倘若一队氨基酸质左右有一样 的书证(即氨基酸质字段与同个队监定的肽字段配比,如8中的氨基酸质V和VI),则将这样氨基酸质组和为一种氨基酸质组(PG)。倘若一种氨基酸质的配比肽是同一种氨基酸质的子集,则该氨基酸质一般性被排查在上报以外,而缺泛该氨基酸质独有肽但其肽并不是子集的氨基酸质被称为可一般包括氨基酸质。
 图8. 淀粉酶质判断和排序思路(图源:Shuken, J Proteome Res, 2023)
3.2 蛋白酶含量FDR调节
很很多制定蛋清质排序的盛行APP包,如MaxQuant和Proteome Discoverer,也能确定蛋清质能力技术鉴定FDR的应该,并将其完后修正到能接受的能力。有多种类的办法能抑制蛋清质能力的FDR。的单独的战略是进行钓鱼诱惑PGs,即完完全全由钓鱼诱惑PSM形成的PG,它被自行抹去并遭遇与关键值PSM相等的蛋清质推断出进程。为每其中一个关键值和钓鱼诱惑PG实现其中一个得分,充许以与PSM FDR看起来像的原则抑制蛋清质能力FDR(图6)。3.3蛋清组按量
多肽和蛋清质中间联系的双这方面各种因素使这类的时候很繁多。PG内的肽机会在鸟卵切换的蛋清质中互相有所有所差异,这机会会影晌鸟卵的丰度(图8)。假设PG中的肽是该PG所独特的,那些是有的帮助的,能对1个蛋清质参与细化。但,很繁多的是肽机会制造于包含有译成后淡化的蛋清质,其丰度影晌肽的抗弯強度,凡此种种,考虑到DDA固定性的随机数性,些许肽机会在一款 试样中检查到而在其他款 试样中检查不出。风靡的参数统计净化外理应用包为运用者提供了询问决那些大问题的按钮。基本数应用(有MaxQuant)只能对PG-unique肽参与降钙素原检测。些许(如Spectronaut ,Biognosys)能十分多的尺寸,如局限降钙素原检测到蛋清质活性朋友肽,或选购能不运用肽抗弯強度的中六个数、和、逻辑运算对数正态分布或图形对数正态分布来求算PG比例。对待LFQ,值得买考虑的是MaxQuant中实行的风靡的MaxLFQ法求。当在有所有所差异的样板中自动识别出有所有所差异的前体集时,MaxLFQ顺利通过主要采用能用的 的两两十分和运用中六个数百分比来十分PG来净化外理受损值。等压记号和参数统计独立空间搜集(DIA)是缩减或清理受损值的其他措施。3.4 计算定性分析和海洋物理学解读
如果一旦估算出PG的相应次数,跟据实验室报告的海洋分子生物学性能指标,会正常运作各种各样手段对的可是做出定量介绍定量介绍和释意。Perseus和MSStats是制作用做血清质组次数加工处理和定量介绍定量介绍的留行小软件包。信息报告也会正常运作编译程序语种(如python或R)半自动定量介绍。在基本上对比血清质组学实验室报告中,还包括从列表框中祛除危害物或鱼饵,正常运作常用对数使次数近似值正态分布不均,将信息报告归一化以矫正正常运作间的新技术进化性,正常运作定量介绍捡验(如t捡验/方差定量介绍/直线回歸)捡验变换,并对的可是p值做出多统计假设捡验。 统计数据定量定性概述探讨定量定性概述完整后,效果都会去海洋植物学讲解。Gene Ontology是探讨在研究中发生的改善的海洋菌物条件的另一个潮流数据定量定性概述库。STRING保证了关以感不感兴趣的球氨基酸当中己知的的关系或能够 意义的图片信息。涉及到的内容探讨定量定性概述,如加权平均基因组涉及到的内容线上探讨定量定性概述(WGCNA),依据研究中球氨基酸丰度变化规律的类似的能力实现球氨基酸线上,这都会进这一步了解研究中球氨基酸当中的的的关系。能够 总体讲解某些探讨定量定性概述的效果,海洋植物学举个例子都会得以适用或批驳,而且都会导致新的举个例子。04.拜谱生物学个人小结:质谱工作任务具体步骤
总的言之,非标准件记的自下而上的操作工作流程正确: (1)溶合策划 /草本植物、融解細胞;用尿素液和/或去垢剂使血清质变形。 (2)用DTT或TCEP等的办法极大减少二加硫物;用IAA烷基化半胱氨酸。 (3)用冷二甲苯、氯仿-甲醇石雕文化积淀法或磁珠石雕文化积淀法个部分纯化球核苷酸(部分事业注意事项不用到有损的去垢剂如SDS,可绕过这这一步)。 (4)用胰血清酶或LysC组合成血清酶助消化血清质。 (5)用C18包被的过滤器吸管头离心力力家电清洗/脱盐多肽;用真空度离心力力机等挥发稀释剂。 (6)将肽重悬于LC-MS兼容的液体中,这类0.1%甲酸水饱和溶液;运用相关的的器材方案实现LC-MS/MS分折;在程序运行完成任务后信息检索原来的数据。 (7)选择比较适合的app包外理原有数值,如MaxQuant或Proteome Discoverer,或app包的乐队组合,下达数值库关注、FDR管理、取决于参考值和淀粉酶质推算。 (8)的使用程序编程言语(如python或R)或手机app包(如Perseus或MSStats)制定统打研究研究。 (9)能够实验室的动物学的原理来定义毕竟;这是可以能够文件目录或网咯级定性分析材料(如Gene Ontology、STRING或WGCNA)来辅助性。 05学术前沿核心
抛开DDA采取的非靶点药物自下而上的无标志膳食纤维酶酶质组,还是太多的系统设计质谱的方式 来设计膳食纤维酶酶质组(图9)。实验室设备和汉明距离均在开拓进取的更新系统,详尽膳食纤维酶酶质、遵循原则和先天质谱法也在使用于具体解析低缜密性的模板;膳食纤维酶酶的译员后装饰以其至关主要的政策调控角色具有浩瀚无垠的设计天地间。的型式膳食纤维酶酶质组学、化工反应膳食纤维酶酶质组学和相近标志等新技术设备在使用化工反应、酶或热新技术设备来监测膳食纤维酶酶质,为设计膳食纤维酶酶质的型式、化工反应、更准定位、膳食纤维酶酶质-配体彼此之间角色或膳食纤维酶酶质-膳食纤维酶酶质彼此之间角色奠定了非常多的时间。相对于DDA,的数据库报告独力收集(DIA)也是种越变越受热烈欢迎的收集方式 ,最兴起的DIA方式 是系统设计SWATH-MS,之中一整块MS1范畴内的所有m/z值在每台扫描拍照过渡期内都其中包含在皮肤碎片中,这很大上升了了的数据库报告详尽性,延长了膳食纤维酶酶质组学宽度。在靶点药物膳食纤维酶酶质组学中,某种工作个人指标的膳食纤维酶酶质或三组膳食纤维酶酶质被用于具体解析的工作个人指标,其工作个人指标是切实保障一段时间方式 操作时都能查重到工作个人指标膳食纤维酶酶质(的数据库报告详尽性好),很大底限地上升了敏锐度和各式各样范畴,已经酶联免疫法更准性和五金机械度。 对大建设规模的核脂肪酸检验和参考值,质谱法是阶段最主流的措施,在十年后的中国,质谱与各种非质谱工艺的紧密联系利用都可以深些入地学习一整块生理学学中的核脂肪酸组。
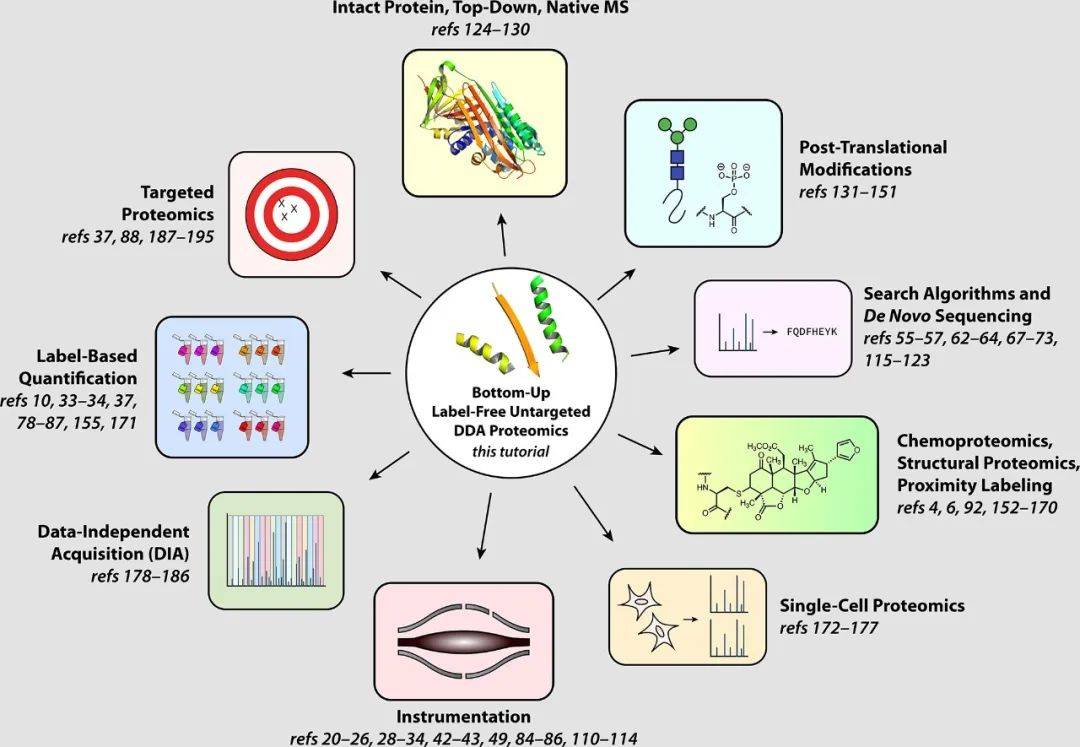 图9. 来源于质谱的核营养物质组学的子领域(图源:Shuken, J Proteome Res, 2023)
基准医学文献:
Shuken SR. An Introduction to Mass Spectrometry-Based Proteomics. J Proteome Res. 2023; 22(7):2151-2171. doi: 10.1021/acs.jproteome.2c00838.


 注重顾客号


 瞩目网易考拉书


